DeepSeek联手华为,能否击穿英伟达CUDA?

“算子语言开辟出新赛道,迂回战法能否化解飞轮?
9月30日,DeepSeek官方公众号发了一条消息,宣布开源面向华为昇腾算力平台的六件基础设施组件,涵盖TileLang高级语言编译工具、计算库和分布式通信库,并且特意强调了一件事,所有组件与此前面向英伟达平台的开源组件一一对应。
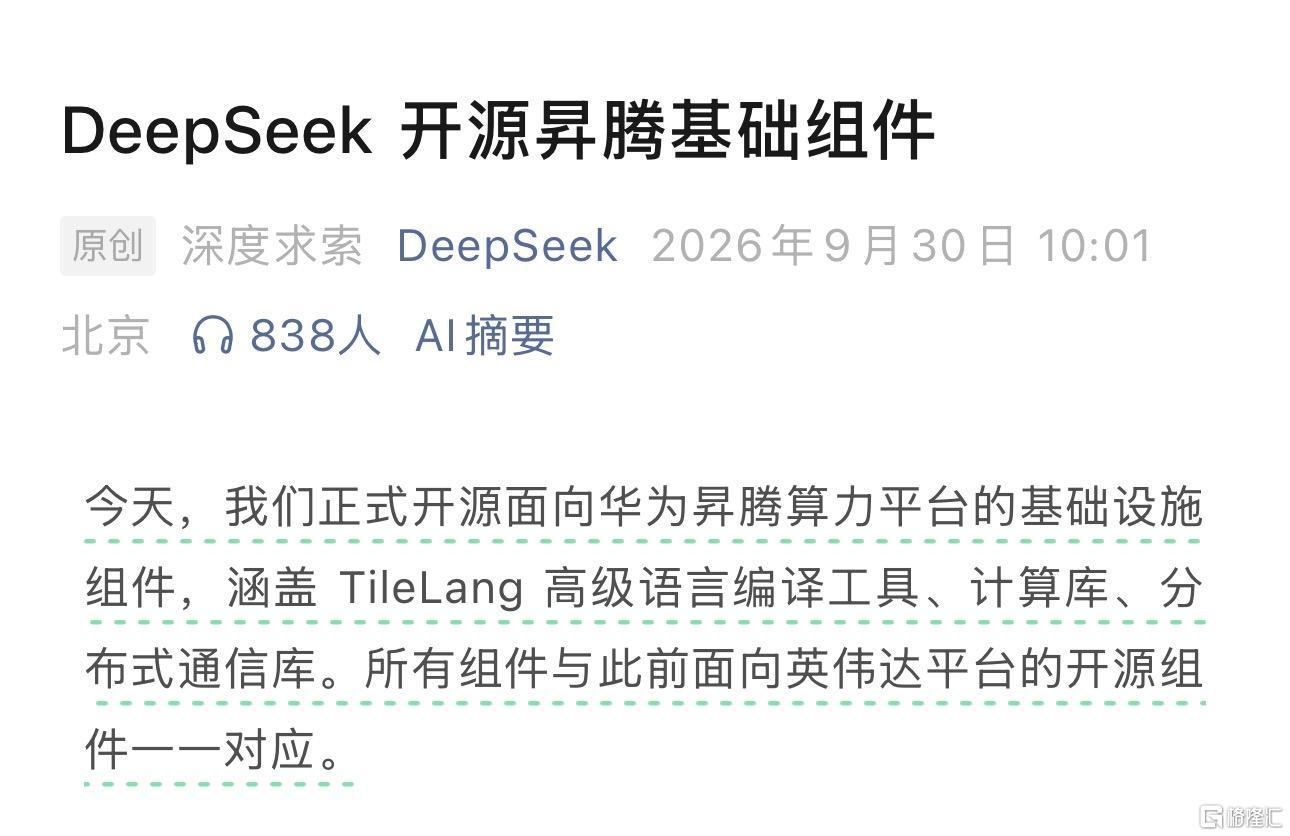
“深度求索”公众号9.30日文章
六件套的分工很清楚。TileLang负责算子怎么写,DeepGEMM加速矩阵运算,DeepEP管跨设备通信,TileKernels覆盖向量计算和访存,FlashMLA优化长上下文注意力,DeepSelect做数据筛选。DeepSeek在公告里说了一句分量很重的话,“TileLang路线已承载了DeepSeek V4系列模型训练中大部分算子的实现”。也就是说,这些不是演示代码,是一个前沿模型实验室训练主力模型时真正在用的东西,现在原样搬到了华为的芯片上。
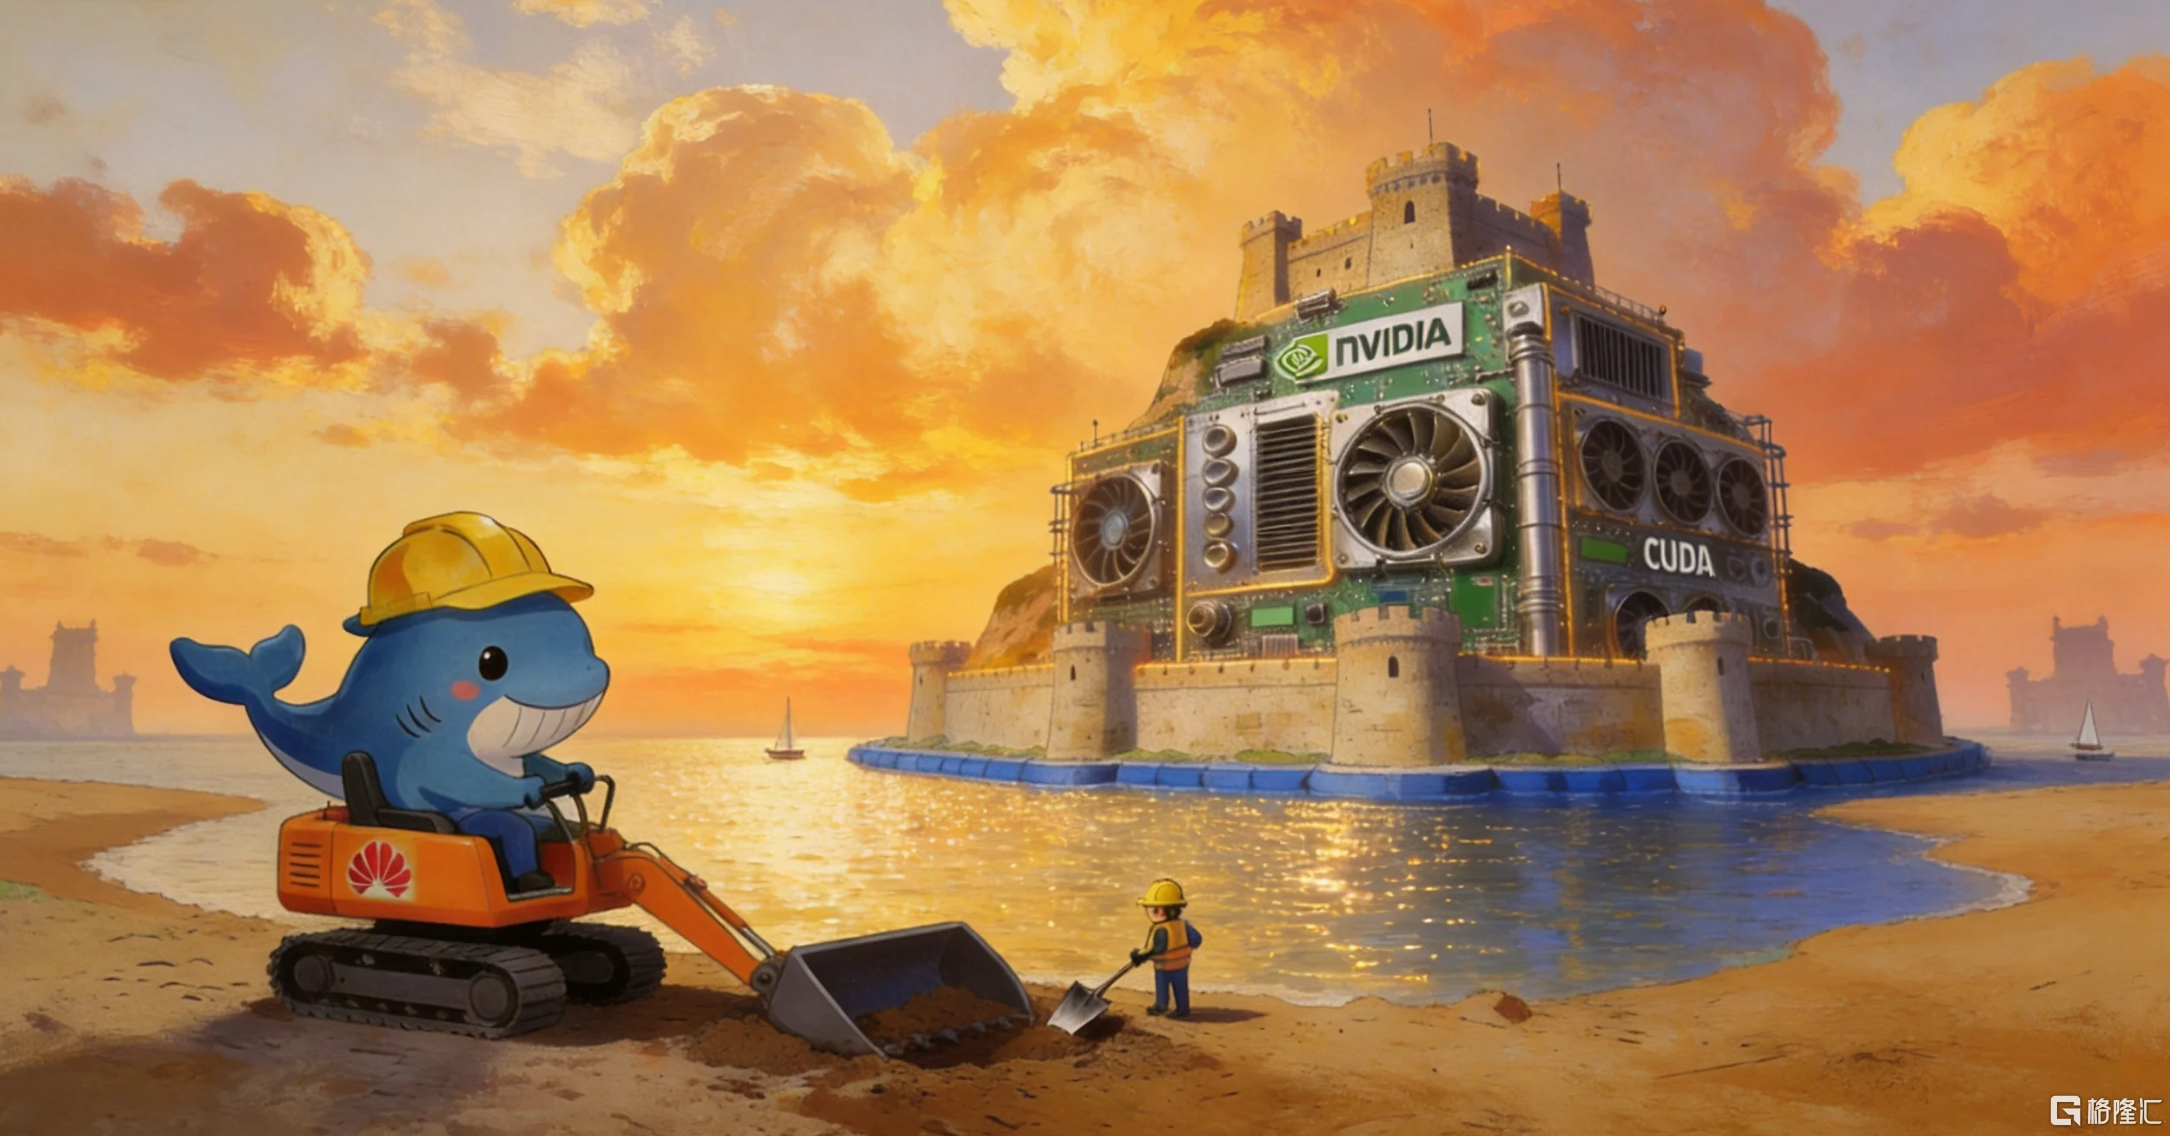
过去两年,关于国产芯片追平英伟达的讨论集中在硬件层面,制程、算力、显存带宽。但业内一直有个共识,英伟达真正的护城河不在芯片,在CUDA软件生态。某种意义上,击穿CUDA生态,与在硬件性能上追平英伟达同等重要,甚至更重要。DeepSeek与华为这次围绕TileLang的联手,是第一次有前沿模型公司认真地向这个方向出手。
问题也就来了。这套组合拳,真能击穿CUDA吗?
CUDA的护城河不是语言,是飞轮
打败对手的第一步是了解对手。
CUDA是英伟达2006年推出的并行计算平台,到2026年正好二十年。今年3月的GTC大会上,黄仁勋用一组数字给它过了生日,全球600万开发者(英伟达自报数字),数千种工具、编译器、框架和库,开源领域数十万个公共项目,全球数亿颗运行CUDA的GPU。
对这组数字,黄仁勋在演讲里给出的战略概括叫“飞轮”。装机量吸引开发者,开发者创造新算法,算法突破开辟新市场,新市场又吸引更多公司加入,进一步扩大装机量。他反复强调CUDA的高度架构兼容性;英伟达高管Ian Buck进一步说明,早期的CUDA 1.0代码经过(重)编译后,仍可在最新架构上运行,且性能提升显著。
很多人对生态壁垒的理解停留在“代码要重写”。这低估了问题的真实形态。英伟达生态里沉淀的东西,是一套生产AI系统时做出的数千个微小工程决策,内核优化,混合精度训练路径,调试和性能剖析工作流,以及默认CUDA存在的CI/CD流水线。这些不出现在任何芯片参数表上,换平台时却要全部重做一遍。
再加上人才供给。大学课程教CUDA,技术社区的问答沉淀在CUDA,一个工程师数年积累的调优经验无法随代码迁移。据券商研报援引的行业统计,CUDA 生态已覆盖超过400个加速库、600个AI模型、3700个GPU加速应用,英伟达在服务器GPU市场的份额约97%。英伟达超过70%的毛利率,定价权的很大一部分就压在这套生态上。
用大白话来讲,CUDA的护城河不是这个语言本身多好用,而是全世界的代码、教材、调试工具和工程师经验都长在它身上。搬家不是搬行李,是连人一起搬。
换轨:TileLang把算子和硬件拆开
理解了护城河,就能看懂DeepSeek和华为选择的打法。他们没有去正面复制一个CUDA,而是换了一条轨道,在算子编程这一层垫进一个可移植的中间语言,把“算子代码”和“具体硬件”拆开。
TileLang的出身并不神秘。它由北京大学计算机学院杨智课题组主导开发,2025年1月在GitHub开源,是一种领域专用语言,采用类Python语法,设计思想是把数据流逻辑与底层调度(线程绑定、内存布局、流水线)解耦,让开发者专注写计算本身,优化大部分交给编译器,专家需要极致性能时又能下沉到线程级控制。换到工程语言,就是既好写,又不牺牲性能上限。
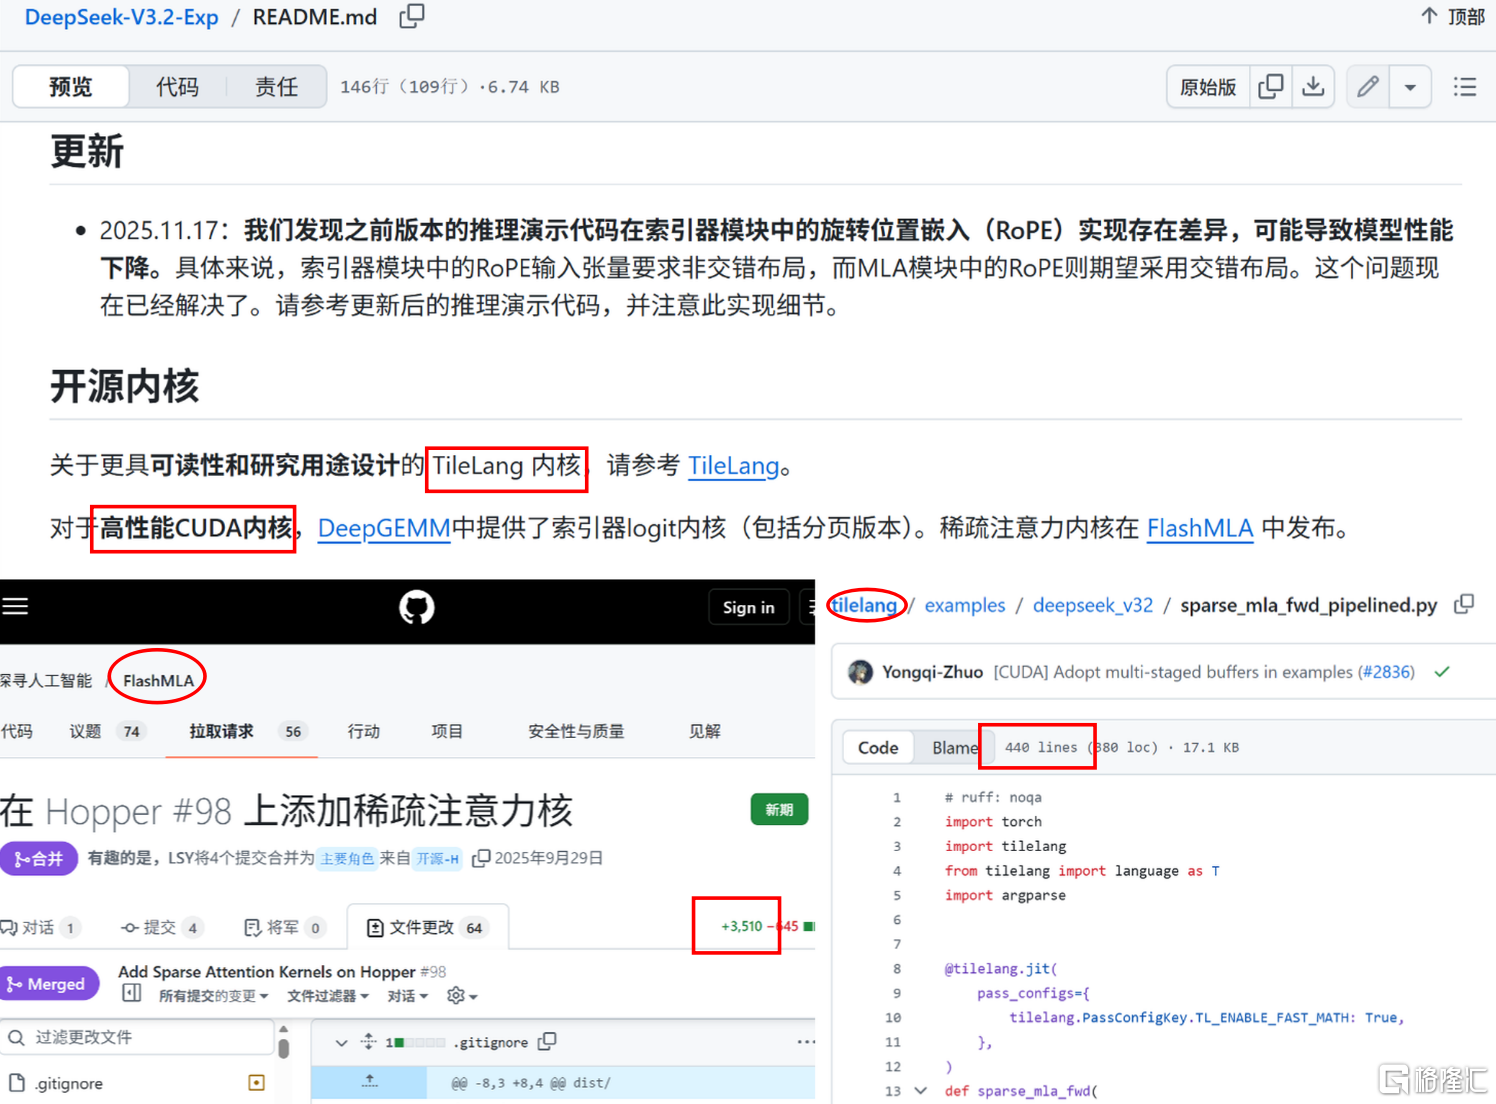
同一DSA稀疏注意力组件,官方指定的TileLang与CUDA双版本实现对比。
左下:CUDA 右下:TileLang
真正的转折点是DeepSeek的采用。2025年9月,DeepSeek发布V3.2-Exp模型时,同步开源了TileLang版算子,官方明确建议社区做研究实验时使用TileLang版本。据TileLang团队成员在华为全联接大会2025开发者日的分享,用TileLang实现FlashAttention算子,代码量从500多行减少到80行,性能与官方版本持平。到V4系列,TileLang已经从“快速原型工具”升级为承载训练中大部分算子实现的生产级路线。
关键的技术事实是这一条。TileLang在英伟达平台上编译为CUDA代码,在昇腾平台上封装的是华为的Ascend C底层指令。同一份用高级语言写成的算子代码,可以面向两类完全不同的硬件。DeepSeek在公告中表述为“其训练中用到的每一个TileLang算子,在昇腾上都有对应的高性能实现”。
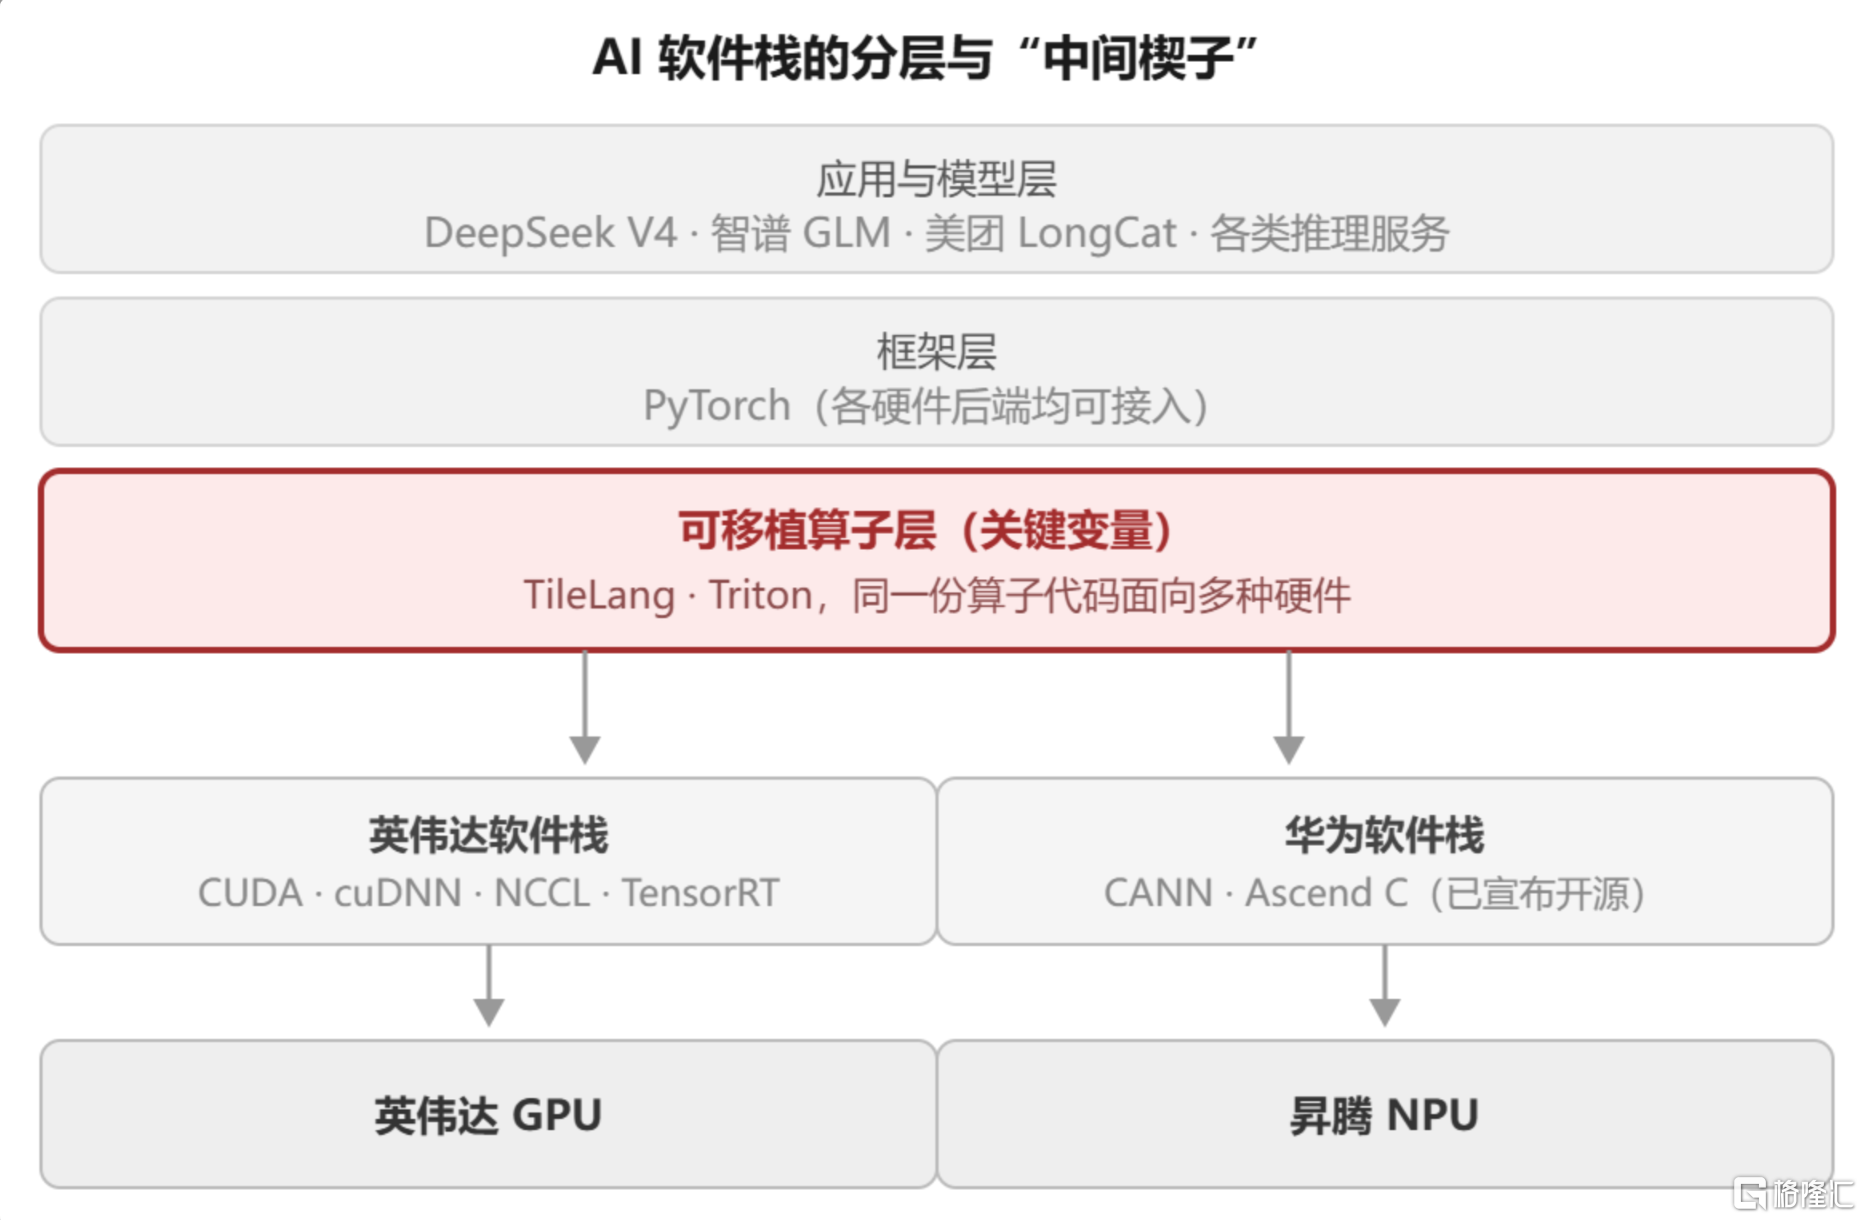
"楔子"运行示意图
这个打法不是DeepSeek一家的选择,方向已经成了行业趋势的汇流点。据公开报道,摩尔线程在2026年2月开源了TileLang-MUSA项目,在其MTT S5000 等多代GPU上完成验证,用TileLang开发大模型关键算子,代码量较手写 MUSA C++减少约90%,GEMM性能最高达到手写优化版本的95%。沐曦的高级总监与TileLang团队同台讨论过GPU适配,山东大学等机构推进过TileLang 对算能TPU的支持,微软BitNet模型的量化算子库BitBLAS也使用了TileLang开发。
这里有一个容易被忽略的结构性变化。CUDA生态锁定的对象,传统上是数百万通用开发者。但大模型时代的核心算子,稀疏注意力、MLA、MoE通信,早就不在cuDNN的现成清单里,而是由少数前沿实验室自己编写。算子编写的重心从长尾开发者收敛到了头部模型公司和编译器团队。锁定的目标人群变小了,撬动它所需要的组织数量也从数百万变成了几十家。这是TileLang这类语言能快速站住脚的宏观前提。
华为这边也变了:
从自建生态到进生态
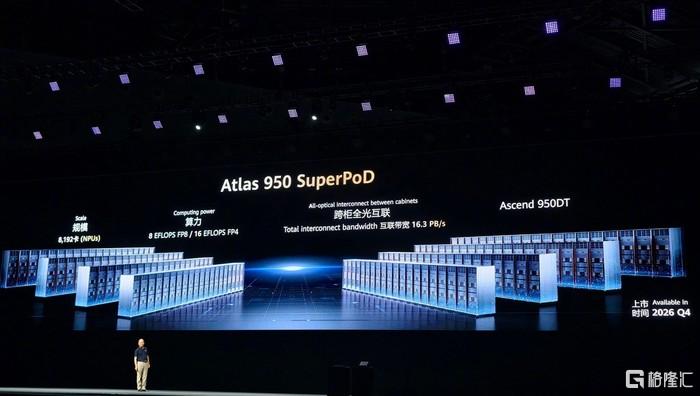
Atlas 950 超节点发布会
楔子打进去前,华为自己也改了打法。昇腾软件生态这五年的路径,含着三次清晰的战略转向。
第一阶段是2020到2023年,华为试图复制CUDA的路线,用自有的 MindSpore框架加CANN算子架构建一套完整闭环。这条路撞上了冷启动困境。开发者面对全新的Ascend C语法和算子开发流程,一个在CUDA上跑通的模型迁移到昇腾平均需要数周,文档覆盖不住边缘场景,用户少导致问题修复慢,用户更少。结论很清楚,在一个成熟生态面前,用另一套等价但不兼容的体系去竞争,迁移成本远大于性能收益。
第二阶段是2024到2025年,华为转向兼容PyTorch,开发者的模型代码一行不用改,只需要把设备声明里的“cuda”改成“npu”,程序就能在昇腾芯片上跑起来。方向对了,但适配层在一些场景里带来了性能损耗,用开发者的话来说是“能跑,但不够快”。
第三阶段就是现在。徐直军在HC2025上宣布,CANN编译器和虚拟指令集接口开放,2025年底前完成开源,此后与产品上市同步开源。到了2026年,华为进一步在开发者大会上公布了全面开源的数字,800多个算子,对Triton和TileLang接口都做了兼容,对齐2300多个PyTorchAPI。代表华为战略姿态发生了根本变化,不再要求开发者迁移过来,而是把自己改造成开发者已经在用的样子。这次昇腾支持的不再是“昇腾生态”,而是“主流生态里多了一个昇腾后端”。
硬件侧同步换了解题思路。徐直军在HC2025的原话是“AI算力不等于芯片性能,单颗芯片性能的短板可以通过超节点加集群的方式解决”。具体产品是 Atlas950超节点,基于昇腾950DT芯片,支持8192张卡作为一个逻辑整体工作,FP8算力8EFLOPS,互联带宽16.3PB/s,内存容量1152TB,按华为口径,对比英伟达计划2026年下半年上市的NVL144,卡规模是对方56.8倍,总算力6.7倍
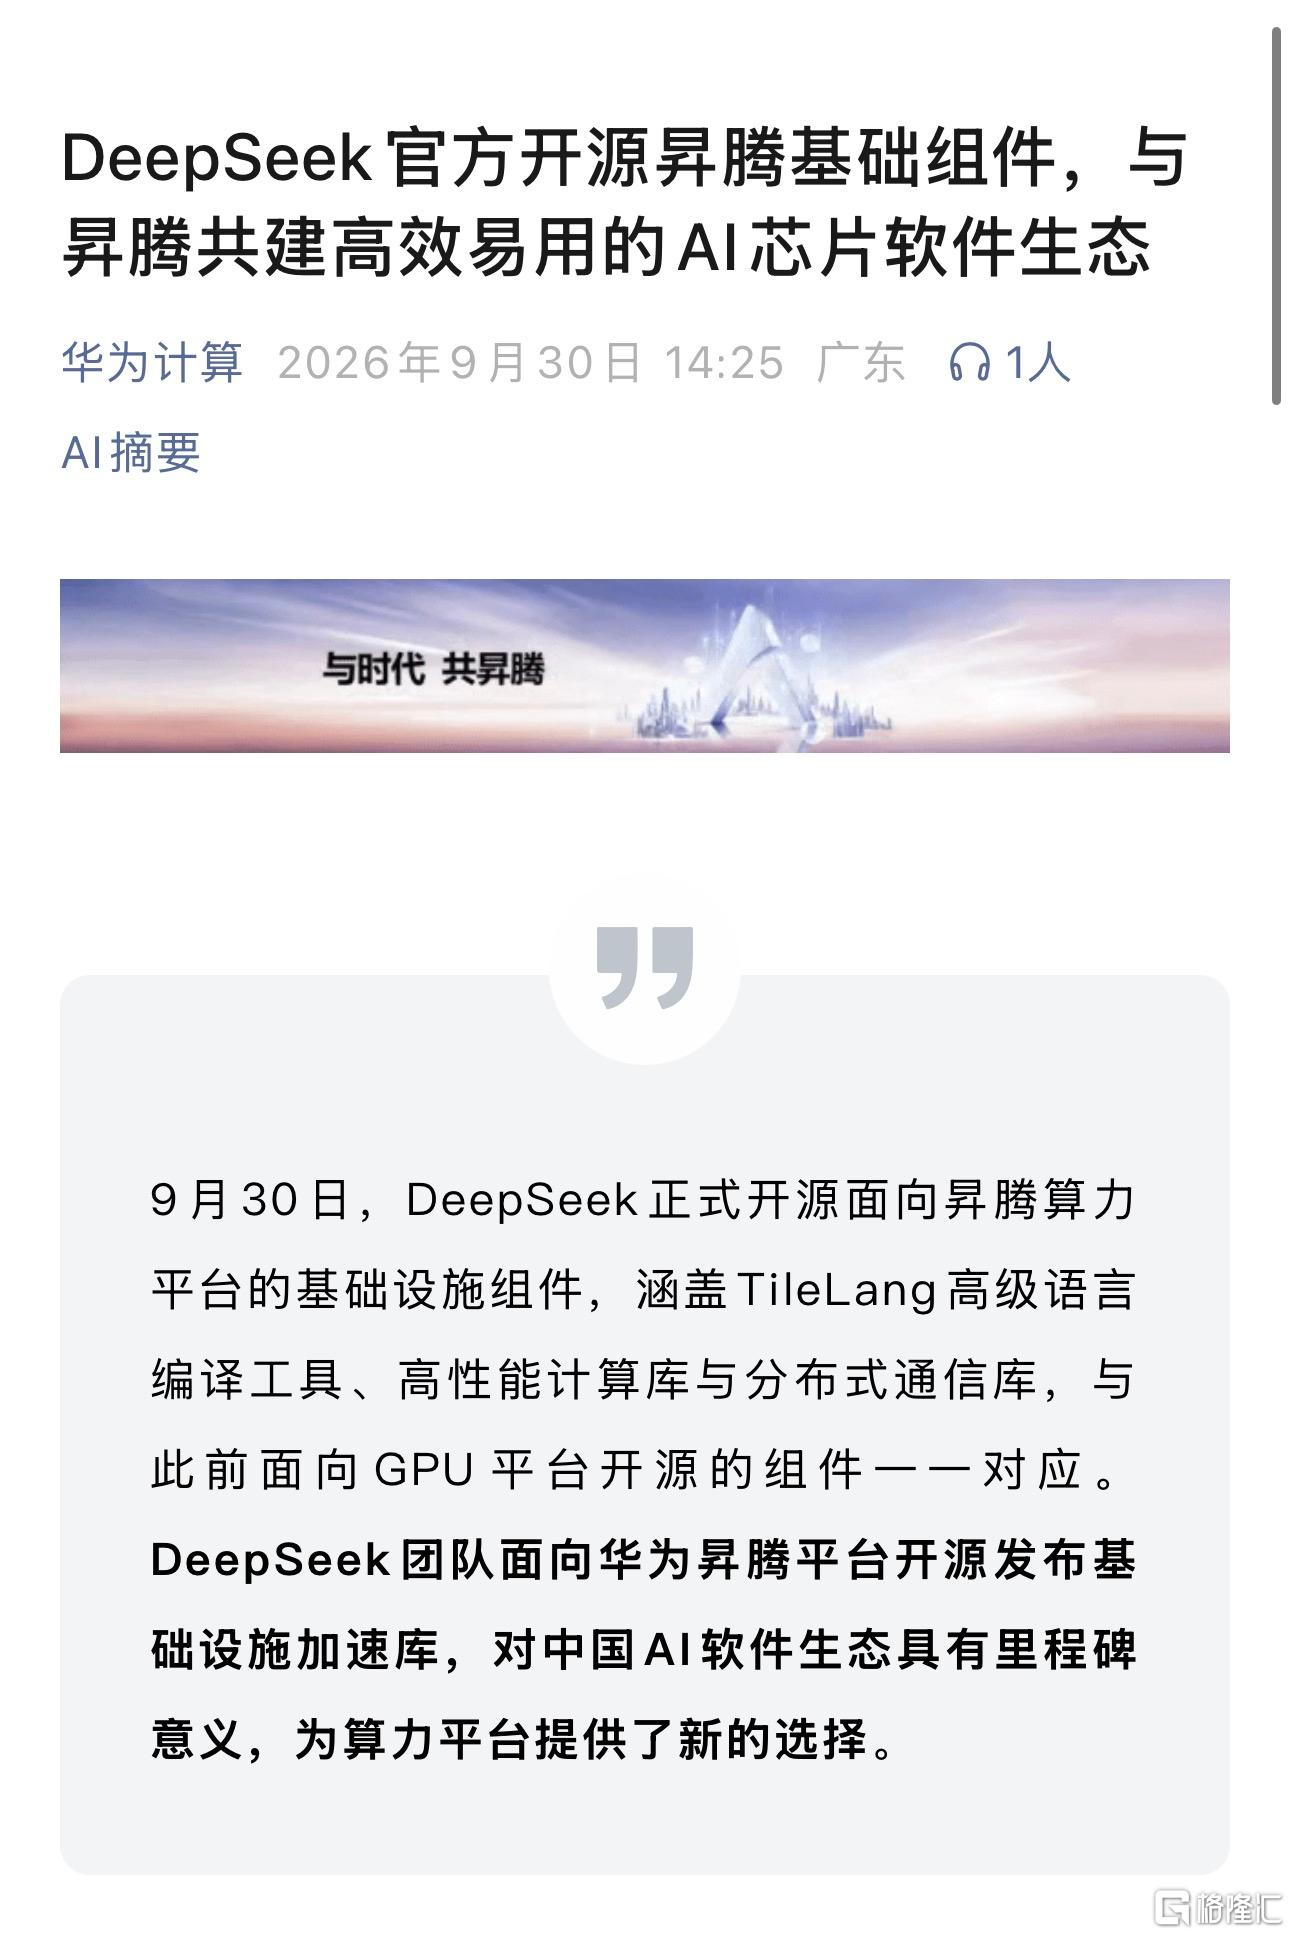
“华为计算”公众号9.30日内容
然后是最值得注意的部分,芯模协同。2026年4月DeepSeek V4发布时,技术报告把华为昇腾NPU与英伟达GPU并列写入了硬件验证清单,细粒度专家并行方案在双平台上完成验证。9月30日,华为在昇腾社区发布的配套文章披露,向DeepSeek提供了联合定义的昇腾超节点方案和UBL128组网,128卡单层交换互联,可扩展到256K卡两层交换组网,支撑大规模训练。在昇腾950DT的 EP8配置下,DeepEP的Dispatch实测373到375GB/s,Combine 345到 347GB/s,接近硬件上限。
不止这些,双方的绑定可能还在加深。据证券时报报道,DeepSeek新一轮融资规模或达千亿元,投向包括基于国产算力的预训练,而此前国产算力从未真正进入前沿模型的预训练市场,DeepSeek想做第一个。DeepSeek已在昇腾社区开源了基于昇腾950超节点的V4.1-Flash预训练系统参考实现,而模型公司把训练侧的工程押上国产算力,这在两年前是不可想象的。
但“击穿”这件事,要连斩五刀
CUDA花了20年,不会打磨出一把钝刀
第一,全球范围内“击穿”短期是伪命题。CUDA的装机量、大学课程、调试工具链和数十万开源项目都在,英伟达整体营收还在高速增长。DeepSeek和华为的动静发生在中国市场,英伟达的基本盘在北美、欧洲和中东的AI数据中心,后者今天没有理由更换轨道。
第二,TileLang只覆盖算子层,不覆盖全栈。CUDA生态包含cuDNN、NCCL、TensorRT、Nsight以及二十年沉淀的社区问答和行业应用。算子怎么写只是其中一环,性能剖析、调试、推理引擎、行业解决方案,这些环节的生态差距没有被动过。CANN生态的历史痛点,算子融合不够智能、集群通信延迟抖动高于NVLink、文档缺口,也只是缓解,没有消失。
第三,DSL不等于性能保证。2026年7月一篇来自得克萨斯大学达拉斯分校的实证研究测试了22个Triton和TileLang内核,其中一个通过正确性检验的TileLang LayerNorm内核,跑起来比PyTorch基线慢300倍以上,卷积和大型GEMM在优化后仍残留结构性差距。可移植语言的性能方差极大。大白话来说: 写得对和跑得快是两回事。DeepSeek的组件能在多项测试中接近硬件上限,靠的是自家工程团队和华为的深度联合优化,这个门槛普通开发者够不到。
第四,英伟达没有站着不动。黄仁勋在去年12月就宣布在CUDA中引入Tile架构,构建了让OpenAI的Triton直接编译到CUDA Tile IR的后端。分块编程这个范式,英伟达正在把它收编进自家软件栈。楔子打法英伟达看得懂,也在用。
第五,硬件约束没有解除。徐直军本人承认中国半导体制造工艺将在相当长时间处于落后状态。昇腾950DT能否按期在2026年四季度量产交付、Atlas950超节点能否批量部署、V4-Pro的降价承诺能否兑现,都是还没有落地的承诺。DeepSeek千亿融资投国产算力预训练,据证券时报的说法,性质是“豪赌”。
对行业的影响:
分层、共享与协同设计
即使不谈“击穿”,这件事对行业结构的改变也已经开始了。
影响一,算子语言成为新的必争之地。过去竞争发生在“芯片vs芯片”和“生态vs生态”两个层面,现在多了一层“可移植算子层”。这一层的价值由Triton先验证(它已是PyTorch编译器的默认内核生成路径),TileLang用更强的底层控制能力接着推进,英伟达则用Tile IR把这一层往自家收。三方都在争同一个位置,这个位置本身的价值已经无需再论证。
影响二,国产芯片开始共享软件层。此前国产AI芯片最致命的问题不是单颗芯片的性能,而是每家都要建一套自己的生态,开发者为华为写一版、为摩尔线程写一版、为沐曦再写一版,谁也攒不起规模。TileLang同时跑在昇腾、摩尔线程MUSA、沐曦和算能TPU上,一个共享的算子层把碎片化的软件成本摊平了。DeepSeek把这份示范开源,等于给所有二线芯片厂商指了一条接入路径。
影响三,“芯模”协同成为前沿标配。DeepSeek与华为联合定义超节点只是最新的例子。同一时期,智谱GLM-5.1发布当天上线华为云,据华为云披露在昇腾上实现层级MoE均衡、整体吞吐提升30%。模型架构为芯片特性设计,芯片为模型负载优化,这条协同链路一旦跑通,就不再是单点新闻,而是新的生产方式。
影响四,出口管制产生了反身性。禁令的本意是限制中国获得先进算力,实际效果是给国产算力生态送去了确定性最强的需求。买家知道英伟达的供应随时可能中断,模型公司的工程投入就有了长期理由,生态成熟速度反而加快。“如果DeepSeek的新一代模型率先选择在华为先进芯片平台上全面适配,那对美国(全球人工智能领域的战略地位)而言,无疑将是一个可怕的结局”这是黄仁勋的原话
结论:CUDA不会被替代,但正在被旁路
回到标题的问题。DeepSeek联手华为,能否击穿英伟达CUDA?
我的判断分两层。
在全球市场,答案是否定的。CUDA的二十年积累、数亿装机量、六百万开发者(自报口径)和最完整的生产工具链,在可预见的时间内没有等价替代物。英伟达的整体业务仍在增长,Tile IR的推出同时说明它对范式变化的反应速度并不慢。
在中国市场,答案是进行时,但准确的说不是“击穿”,是“旁路”。TileLang这类可移植算子层不需要杀死CUDA,它只需要让最前沿的算子编写不再与CUDA绑定。CUDA从“所有道路的起点”变成“可选的后端之一”,这个身份变化本身就是护城河的实质性收窄。生态锁定的溢价一旦松动,英伟达在中国市场曾经拥有的定价权就回不来了
回到2006年,CUDA发布时没有人认为它重要。回到2025年1月,TileLang开源时star数花了数月才到两千。护城河都是这样一锹一锹挖出来的,也都会是这样一锹一锹被绕开。英伟达用二十年证明了生态的价值,现在轮到它的挑战者证明,生态的价值也可以由另一种方式达成,不靠锁定,靠共享。
文:喆涵 / 数据猿
责编:凝视深空 / 数据猿
格隆汇声明:文中观点均来自原作者,不代表格隆汇观点及立场。特别提醒,投资决策需建立在独立思考之上,本文内容仅供参考,不作为实际操作建议,交易风险自担。