从“采得多”到“用得上”:具身智能的第一场淘汰赛,从数据开始


摘要:具身智能的“数据孤岛”能被一份文件拆掉吗?
先讲一个已经发生过的场景。
2026年1月,湖北人形机器人创新中心与智元完成了全国首笔企业间具身数据交易。交易的是涵盖拿杯子、抓盘子、叠衣服等场景的数千小时训练数据。
具身数据交易有了,但一个尴尬的问题紧接着就来了:同样是一小时数据,真机遥操作采的、无本体采集设备采的、仿真合成的,价格从几百到上千,凭什么?同样是“完成任务”,A厂的日志和B厂的日志,能不能放在一起比?
没有人能给出标准答案。因为行业还没有一把统一的尺子。
这就是2026年11月10日全国数据标准化技术委员会成立具身智能数据标准起草工作组(WG7)的真正背景。新闻本身说的是“启动标准预研、补齐数据侧标准短板”,但翻译成行业语言,它要回答的其实是那个“凭什么”的问题。
一、采集再多,读不懂就只是库存
标准不是从今天才开始做的。
2026年3月,70余家企业参与标准编制的《人形机器人与具身智能标准体系(2026版)》发布;11月1日,信通院牵头、40余家单位共同起草的YD/T 6771—2026《人工智能关键基础技术具身智能数据集质量要求及评价方法》正式落地。WG7的成立,是这条线的延续。
但为什么是现在?因为行业已经走到了必须算账的阶段。采得再多,如果不能互相读懂,数据就只是库存,不是资产。
为什么现在必须立标准?
理由一:缺口大,但小时数不是质量指标
据信通院的说法,全球可用的高质量真实数据只有数十万至百万小时级,而具身基础模型要迎来“ChatGPT时刻”,至少需要数千万小时,供需相差约两个数量级。
价格也印证了稀缺。据行业公开报价,真机数据参考价格约在300元至1000元一小时,无本体采集方案约在100至300元一小时。
但智元机器人联合创始人、觅蜂科技董事长姚卯青曾言:“重复做同一种任务,即使很快堆到100万小时,也可能没有太大训练价值。小时数是产能指标,不是质量指标。”
问题不在于让行业采得更多,而在于让已经采到的数据能够算数。
理由二:孤岛,数据难复用
具身智能的技术路线尚处百家争鸣期,企业内部、不同企业与科研机构的数据集建设工作相对独立,数据格式各异、语义标注自成体系、机器人本体的传感器配置与控制模态千差万别,有价值的数据难以跨主体、跨场景复用。
一个人形机器人采集与训练中心,就需要采购不同品牌、不同类型的的机器人,才能用“不同的身体”,产出“通用的数据”。
但现实是,每家的机器人说的都是自己的“方言”。
理由三:技术路线还没收敛,三条路线并行烧钱
数据供给当前有三条路线并行:真机遥操作(觅蜂、帕西尼等)、无本体采集(鹿明的FaseUMI)、仿真合成。
据量子位对70家数采公司的统计,43%的玩家同时走多条采集路线,跨路线玩家数量超过了单独押注任何一条的。
43%的公司同时在三条路上烧钱,这不是战略选择,这是战略焦虑。行业自己都还没想清楚哪条路是对的,所以全都在铺。
这就需要在路线未定的时候,先把“数据长什么样”定下来,否则每条路线产出的都是不同规格的原料,谁也没法跟谁拼接。
理由四:钱在集中,但资源在重复
具身智能数据侧企业作为“淘金热”中的“卖铲人”,颇受资本青睐。
以光轮智能为例,天眼查APP显示,光轮2023年1月成立,2026年3月完成10亿元A+轮,成为全球首个具身数据独角兽,估值超150亿元。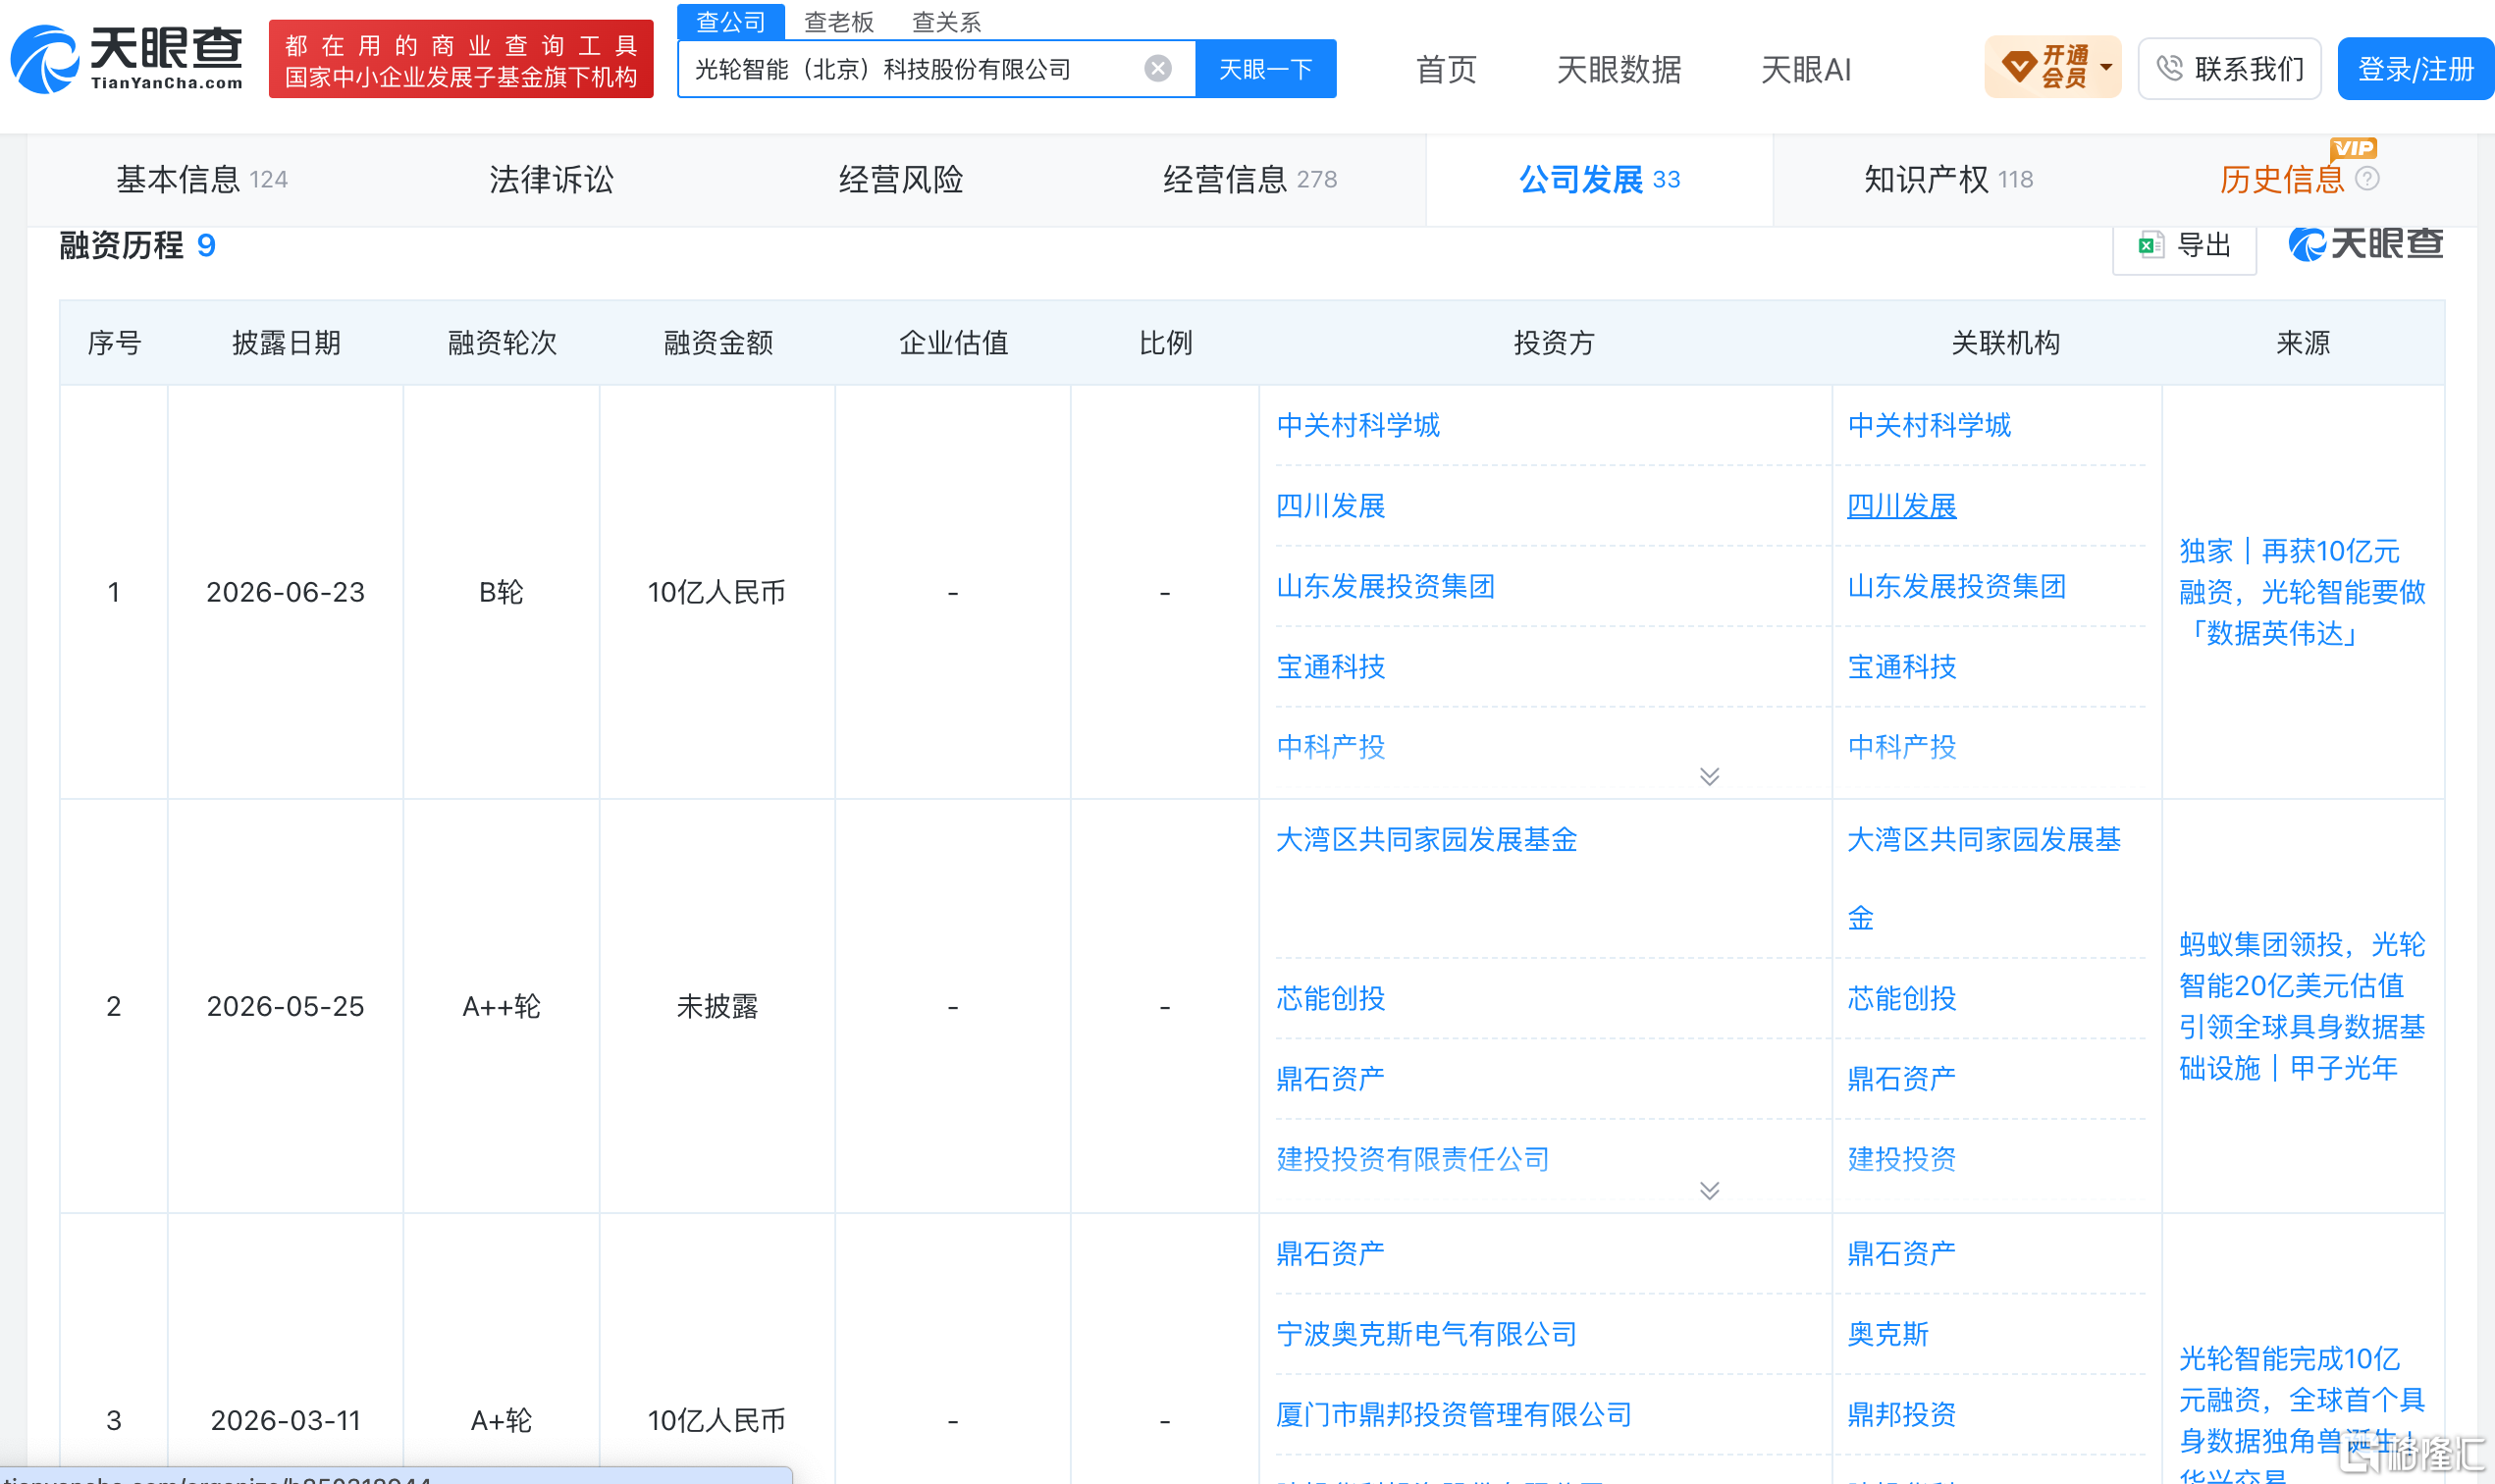
(图源 天眼查)
但产能这头比较分散。
据中国信通院2026年8月发布的《具身智能训练场研究报告(2026年)》,截至2026年6月底,全国建成启用超70家具身智能训练场,在建或规划中的有46家。
70家训练场,在做类似的事,采类似的数据,用互不相通的格式。这不叫竞争,这叫重复。
理由五:交易有了,但定价还靠“拍脑袋”
具身数据有了交易之后,配套政策也在往前推。南京玄武区对入场交易的具身数据集按成交额10%给予供给方补贴,单家企业年度最高500万元。
但问题恰恰在这里:交易有了,定价却没有锚。
同样是一小时数据,真机采的、无本体采的、仿真生成的,价格从几百到上千,凭什么?
所以说,交易一旦开始,计量就必须统一。否则每一笔买卖都是一次单独的谈判,市场永远长不大。
所以推进数据标准,与其说是政策在推动,不如说是行业已经走到了必须算账的阶段。
二、标准定在之上,利益分在桌上
先说受益的一面:竞争维度从“采得多”到“用得上、卖得掉”。
过去两年,行业比的是谁采得多、谁的场景多、谁的数据量大。标准落地后,比的是另一组指标:谁的数据能被复用、能被交易、能进别人的训练管线。
数据多,是资产;数据能被别人用,才是资本。
未来具身智能数据采集公司赢家是“能复售”的一方,不是“能采”的一方。
以光轮智能为例,核心模式是“数据复售”。
即同一份高质量数据,加工成标准化产品后,可以同时卖给智元、银河通用等多家头部机器人公司,部分优质场景数据的复售率超过10倍。采集成本是一次性的,数据资产可以反复变现。
觅蜂科技走的是另一条路,逻辑相似。
据觅蜂科技公开披露,MEgo设备累计下线2万台,累计产出超100万小时数据,覆盖22大类场景、1万余个真实环境;第2万套设备已交付京东,京东提出两年内积累1000万小时真实场景数据的目标。
它用“自营加生态代工”,通过平台调度、标准输出、订单分发扩张产能,本质也是“卖标准加卖调度”。
这几家的共同点在于,它们卖的不是“数据本身”,而是“可被反复出售的数据形态”。
而标准做的,恰恰是让“同一种形态”成为行业通用。格式统一之后,一份数据的可售对象,从一家变成了所有能读这个格式的人。
所以标准最直接的受益者,不是采得最多的公司,是复售率最高的公司。
但这里立刻要踩一脚刹车:标准制定就是一张牌桌。
在这一过程中,谁坐上去,谁就有机会把自己的“数据语言”变成行业的“普通话”;谁没坐上去,以后要么学别人的语言,要么花钱请人翻译。
参与标准起草或被参考的企业,有机会把自己的数据路线变成行业默认选项;未参与的企业,面对的不只是一次性的适配成本,还有可能是结构性的出清风险。
这不是垄断,但它是标准制定中最真实、也最容易被忽略的竞争红利。
另一方面,标准会推动集中,但集中有它的边界。
有了标准之后,各供应商之间数据可量化,跨供应商对接成本下降,采购方自然向“量大、质稳、格式合规”的供应商集中。
这个路径和手机充电接口统一很像,统一之后,不是每家小厂都消失了,但充电宝生意确实向头部集中了。
也就是说,标准会让数据变成可计价的东西。而一旦可计价,议价权就会从“谁能采”,转向“谁能稳定地采出可复用的数据”。
但是,标准不是万能药。
第一,标准管不了本体。灵巧手从两指到五指不等,不同机器人的自由度、连杆、传感器全不一样。
据公开报道,北京人形机器人创新中心一家,就采购了10余个品牌、120余台不同构型的机器人,就为了适配不同企业各自的数据要求。如果要提高数据的流通性,机器人本身的构型标准也要相对统一。而具身智能数据标准起草工作组只管数据。
第二,标准管不了数据从哪来。 真机数据必须靠机器人在真实场景跑出来。标准能让数据可比,不能让数据变多。
第三,标准管不了商业模式。
2026年9月,美国机器人数据公司Eidon AI宣布关闭,运营两年多。关闭前,团队开源了近两年全部积累,包括1274小时第一人称居家操作数据,共13451段人类日常任务录制。
创始人Sam Padilla的复盘时曾说:“具身智能训练数据匮乏的问题依然存在,但这些数据的价值,未必足以支撑一家独立公司的研发、硬件部署、采集运营和销售开支。”
缺口大,和数据生意能赚钱,是两件事。
第四,标准管不了技术路线收敛。 43%的公司同时走多条路线,本身就说明路线选择还没有答案。
所以标准能做成的事,比想象中少,也比想象中重要。
算力决定谁算得快,标准决定谁的数据算数,最后决定胜负的,还是谁的机器人真能干活。
数据环节正在从“各自采集”进入“规则统一”的阶段。这件事的长期价值是真实的——它能降低重复投入、打开数据复用的技术空间、为中小玩家提供一条留在牌桌上的路径。
但标准能拆掉技术上的墙,但拆不掉利益上的墙。真正的考验不是标准什么时候发布,而是标准发布之后,谁愿意按照标准把数据拿出来,以及谁有能力按照标准把数据用起来。
具身智能的第一场战争不在工厂,在会议室。但第二场,一定还在工厂。
免责声明:本文基于公司法定披露内容和已公开的资料信息,展开评论,但作者不保证该信息资料的完整性、及时性。
另:股市有风险,入市需谨慎。文章不构成投资建议,投资与否须自行甄别。
格隆汇声明:文中观点均来自原作者,不代表格隆汇观点及立场。特别提醒,投资决策需建立在独立思考之上,本文内容仅供参考,不作为实际操作建议,交易风险自担。