蝉联世界第一!“灵晟”能替代英伟达吗?(附股)


当地时间11月17日,在美国芝加哥举行的SC26国际超级计算大会期间,新一期全球超算TOP500榜单正式发布:国家超级计算深圳中心“灵晟”E级超算以2.198EFlops的Linpack双精度实测性能蝉联世界第一,领先第二名美国“El Capitan”(1.809EFlops)约21%,并以22PFlops继续保持HPCG榜单榜首。
“灵晟”(LineShine)是一台部署在国家超级计算深圳中心的国产E级超级计算机。今年6月它就以2.198 EFlops的持续双精度浮点性能首次登顶全球超算TOP500榜单。
灵晟不仅是一台“算得快”的超算,更重要的是它尝试走一条不依赖国外GPU、用国产全CPU架构实现超算与AI融合的新路线。
全栈国产:芯片、网络、存储、软件等核心部分都由中国团队自主研制,没有依赖国外高端GPU加速卡。
全CPU超智融合架构:它没有走传统“CPU+GPU”的异构路线,而是在自研LX2 CPU内部直接集成矩阵加速单元,让CPU同时具备科学计算和AI计算能力。
性能领先:2.198 EFlops意味着每秒约219.8亿亿次双精度浮点运算,目前领先第二名美国El Capitan约21%。
高能效:采用100%全液冷机柜,能效比达到51 GFlops/W,属于非常节能的E级超算。
规模很大:整机由约2.27万个计算节点、约1378万—1379万个处理器核心组成,总存储约650PB。
灵晟主要面向科学、工程和智能计算融合应用,例如:
大气海洋与天气预报
地震模拟与灾害推演
工业仿真、汽车与高端装备研发
新材料设计、生物医药、药物分子筛选
脑科学模拟
大模型训练与推理、AI for Science
灵晟不是“用CPU硬扛GPU”,而是通过片上矩阵加速+HBM+低时延网络+专用推理软件栈,把超算从“只能跑科学计算”改造成“既能跑科学计算,也能稳定输出大模型Token”的融合算力平台。
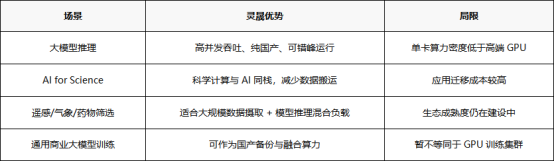
灵晟这类纯CPU超算本身不会直接取代所有GPU集群,但它加上昇腾、海光、寒武纪、摩尔线程等国产GPU/AI加速器共同构成的国产算力体系,正在共同压缩英伟达GPU集群在中国市场的可替代空间。
已经可以替代的场景:
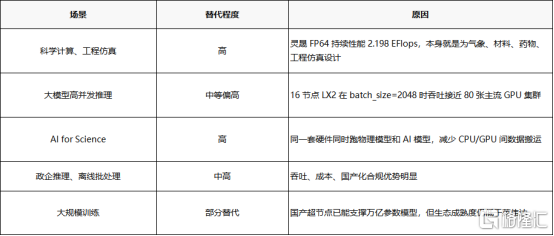
还难以替代的场景:
低延迟单用户对话:GPU在短交互、低并发场景仍有优势。
已有CUDA存量系统:迁移需要重写算子、并行策略和通信库。
前沿训练效率:英伟达在单卡密度、软件栈、开发者生态上仍占优。
海外部署:灵晟主要面向国内超算与政企算力服务,不是通用出口产品。
2026年上半年,中国数据中心AI加速器出货中,非GPU加速器首次超过GPU;英伟达在华出货同比下降约44%,份额降至约34%。
同时,国产超节点、十万卡集群和“国家超算互联网”正在把国产算力从“能用”推向“规模化用”。
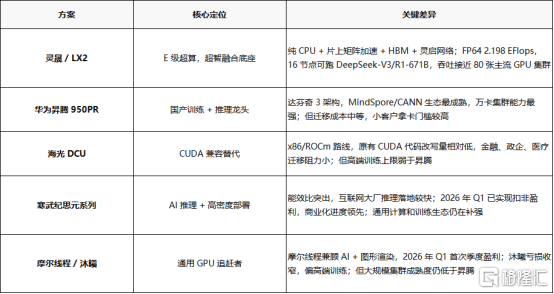
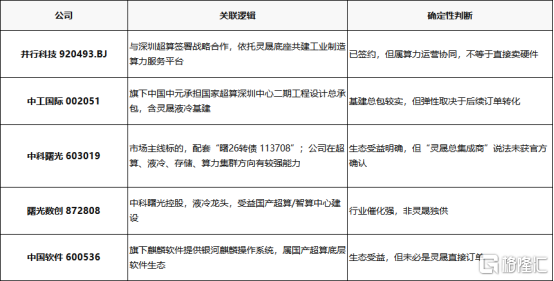
灵晟本身是国家级科研项目,没有独立上市主体,但A股里有不少公司处在它的供应链或生态链上。
第一层:有公开合作/订单线索,确定性相对最高
第二层:国产算力/超算生态受益,但灵晟直接供货未证实
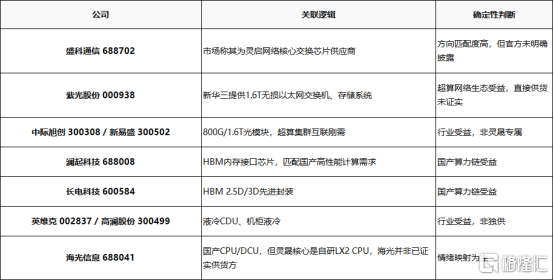
第三层:题材映射较强,需谨慎
寒武纪688256、龙芯中科688047、景嘉微300474:国产AI芯片/CPU/GPU链,但灵晟主线是全CPU+自研LX2,不能简单等同供货。
浪潮信息000977、拓维信息002261、神州数码000034、中国长城000066:更多是国产算力/鲲鹏/昇腾/服务器生态映射,灵晟官方未确认直接供货。
中芯国际688981:市场推测可能承接LX2流片,但尚无官方确认。
格隆汇声明:文中观点均来自原作者,不代表格隆汇观点及立场。特别提醒,投资决策需建立在独立思考之上,本文内容仅供参考,不作为实际操作建议,交易风险自担。