王连印:AI安全不能只靠单点防护,需建立全生命周期防御体系


 图片由AI生成
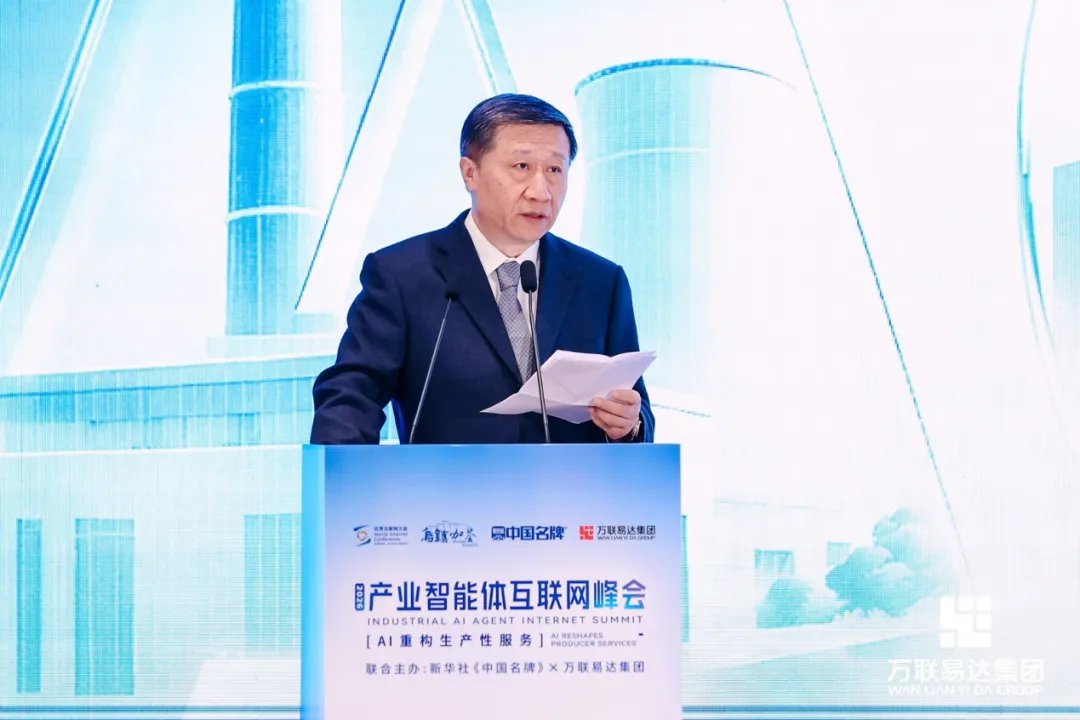
【产联社】“AI时代,数据不只是被处理的对象,也反过来制约大模型的质量和能力。”11月4日下午,中国网络安全审查认证和市场监管大数据中心研究员、原党委书记、副主任王连印在“2026产业智能体互联网峰会”上表示,数据安全问题已从传统的数据保护,进一步延伸到模型、供应链、应用交互和治理等多个环节。
2026年世界互联网大会乌镇峰会期间,万联易达集团联合新华社《中国名牌》举办“2026产业智能体互联网峰会——AI重构生产性服务”乌镇咖荟,王连印以“筑牢AI数据安全底座,护航产业智能化跃迁”为题进行了分享。
王连印认为,从互联网、信息化到数字化,数据的重要性持续提升,而AI进一步放大了数据的价值。大模型从一般内容生成,扩展到长文本、多模态,再到通过MCP等方式连接外部数据源和工具,每一次能力突破,背后都对应数据处理能力的增强。
但数据并非只是被模型处理。数据质量、覆盖范围、结构和反馈也会反过来决定模型“能学到什么、能学多好”,并影响模型的推理、泛化、安全对齐和持续迭代。王连印将其概括为:如果输入数据质量不足,模型同样难以产生高质量结果。
王连印将AI数据安全风险划分至数据层、模型层、系统与供应链层、应用与交互层以及治理与合规层。其中,数据层涉及隐私和敏感信息泄露、数据投毒等问题;模型层可能出现模型后门、权重污染和知识产权风险;供应链则涉及开源组件、工具链和运行环境安全;在应用环节,还可能面临提示注入、越狱和智能体行动风险。
王连印举例称,随着开源模型和组件大量使用,上游数据、模型以及软件依赖本身都可能成为风险来源;而在推理阶段,用户输入的提示词及引用资料,也可能带入恶意内容。
王连印认为,AI安全不能继续依赖单点防护,而应建立全方位、全生命周期的防御体系,并同时发挥技术和制度两方面作用。
在技术层面,可通过隐私计算、差分隐私、数据清洗和投毒检测等手段加强底层数据保护;针对模型和系统,可采用对抗训练、软件物料清单(SBOM)、零信任架构等方式降低供应链风险;在应用层,则可通过输入输出检测、权限最小化、人工介入以及审计溯源等方式限制风险扩散。
制度层面,则需要建立数据分类分级、模型上线前安全评估、供应商安全评估以及全流程责任追溯等机制。王连印对此总结称,要以技术筑牢数据与模型的底座,以制度拉紧系统、应用与治理的缰绳。
王连印还提出,AI安全并非单个企业可以独立完成。特别是需要探索将大型训练场、中试基地等资源进一步转化为可共享的基础设施,提炼出安全服务能力,为安全能力有限的中小企业提供技术支撑,同时推动标准互认、责任共担以及安全与发展的协同。
完整产业数据报告、市场趋势分析,移步「产联社」客户端
格隆汇声明:文中观点均来自原作者,不代表格隆汇观点及立场。特别提醒,投资决策需建立在独立思考之上,本文内容仅供参考,不作为实际操作建议,交易风险自担。